
大模型自己设计芯片?拆解阿里 “芯片‑模型‑云” 协同飞轮

在云栖大会上,阿里巴巴首次集中展示了“芯片—模型—云”的协同优化成果。作为全球少数同时具备自研芯片、大模型和AI云全栈能力的科技公司,阿里已率先在模型自进化、芯片设计和云上算力服务等环节实现协同优化,推动全栈技术能力转化为实际的性能提升、成本下降和规模化应用。
此次展示的核心,是三个技术体系之间的双向反馈:模型和Agent的真实需求牵引芯片与系统设计,云平台将硬件能力组织成可规模化交付的服务,模型再反向优化推理软件和芯片设计。芯片、模型与云由此围绕任务效果、响应速度、吞吐和成本共同迭代,形成协同飞轮。
芯模协同:芯片支撑模型,模型反哺软硬件优化
这一协同已经体现在前沿模型的运行与交付中。据阿里披露,基于真武M890打造的阿里云灵骏超节点实例,已稳定运行Qwen3.8-Max、Kimi K3等超2万亿参数模型,并实现规模化供给。其背后,是芯片、服务器、高速互联、模型软件和云上资源调度的联合优化。截至2026年6月,真武系列已服务超过650家企业客户。
模型也开始探索自主设计芯片,为基础设施提效。仅基于一份真实的芯片模块规范,Qwen3.8-Max就能自主运行超过60小时、调用EDA工具超过万次,完成从功能架构设计、验证到物理实现的完整流程,实现物理面积下降 42%的优化指标。模型能力的增强,让芯片设计成为可迭代、可积累的自主过程,而更好的芯片硬件又将加速模型智能的持续突破,在芯片和模型间形成一个自主迭代的循环。
这些案例呈现出协同飞轮的另一面:芯片支撑模型能力提升,进一步释放硬件性能、改善芯片实现效率。模型能力的进步,开始反馈到支撑其运行的技术基础设施中。
模云协同:贯通训练与推理,提升算力利用率
云平台负责将各环节的优化转化为整体运行效率。训练侧,阿里云通过高速集群互联减少通信等待,通过高性能并行文件存储CPFS提高数据供给能力,再以PAI异步Agentic RL框架串联轨迹采样、回报累计、模型训练和参数更新,支持模型持续迭代。网络、存储和训练框架共同改善,让大规模算力能够更持续地投入有效计算。
基于强大的AI云基础设施,Qwen正逐步迈向训练自我进化。云栖大会上,阿里介绍称,Qwen3.8-Max通过自主搭建训练流程、构造训练数据,并自主设计实验、定位缺陷,在人类完全“零参与”的情况下持续迭代超1个月,完成33轮有效迭代。基于RSI、后训练等系列技术联合优化,Qwen3.8-Max新版本在Artificial Analysis上的得分上涨12.5%,与Claude、GPT最强模型同处第一阵营,领先于GLM5.3、Kimi-K3等所有国产模型。
推理侧,联合优化重点延伸至长上下文和复杂Agent任务的状态管理。随着KV Cache不断增长,模型响应速度和服务成本越来越受到缓存调度与数据搬运的影响。据阿里云披露,在相关场景中,Tair KVCM通过统一编排内存池、KVCacheStore和远端共享存储,实现每Token成本下降50%;KVCacheStore则使首Token响应时间下降54%。
由模型发起的推理自主优化也在加速。在平头哥自研的真武 M890 上,Qwen3.8-Max“从零适配”全新的Qwen3.8-Flash-Next模型,交付了一套可运行的推理栈;相较于首个可用版本,模型优化后实现长文本首 token 延迟和每输出 token 延迟分别下降 47% 和 60%,日常对话场景的单实例吞吐提升 96%。
云芯协同:以真实业务负载牵引芯片设计
来自云上业务的需求,也在反向影响下一代芯片的产品路线。Agent运行既需要AI芯片完成模型推理,也需要CPU承担工具调用、代码沙箱、检索和多Agent编排。对应这些负载,规划中的倚天730面向AI Head Node强化单核性能,倚天720则以192核支持Agentic Rack的大规模并发执行;后续倚天750还将通过ICN总线与真武AI芯片直接互联,提高协作效率。
下一代训推一体AI芯片真武V900,则进一步面向更大模型和更长上下文升级。据介绍,V900搭载216GB显存,片间互联带宽达到1200GB/s,原生支持FP8、FP4低精度计算,计划于2027年第一季度量产,并在阿里云数据中心规模化部署。配合超节点架构与云平台优化,这些硬件能力将为后续模型训练、推理和Agent服务提供支撑。
扩大算力供给,推动协同成果规模化应用
性能与成本优化之外,扩大供给是这一协同体系继续发展的另一项重点。阿里云计划于2026年第四季度新增服务节点,进一步增加云上超节点供给,让芯片、模型和系统优化的成果进入更多实际业务场景。
吴泳铭表示,客户AI需求强劲,全球AI数据中心相关供应链紧缺仍限制算力增长。阿里巴巴将与合作伙伴共同投入AI基础设施建设,目标是到2032年,阿里云运营的全球数据中心规模超过20GW。
此次云栖大会展示了阿里全栈技术投入之间的联系:模型需求进入芯片设计,软硬件优化进入云上服务,模型自身又参与下一轮技术改进。随着这一反馈机制持续运转,单个环节的技术进步有望通过整个体系放大,进一步提升复杂AI任务的运行效率与规模化服务能力。
——附三大基石最新进展:
AI芯片: 升级训推性能并扩大供给
平头哥发布新一代训推一体AI芯片真武V900,其单芯片性能是真武M890的3倍,搭载216GB显存,片间互联带宽达1200GB/s,原生支持FP8、FP4低精度计算,可满足万亿级模型的训练与推理需求。V900计划于2027年第一季度量产,并在阿里云数据中心规模化部署。
系统能力从单芯片延伸至超节点和大规模集群。V900通过自研ICN Switch互联芯片,可实现千卡全带宽高速互联;新一代磐久超节点服务器集成V900、ICN Switch、磐脉智能网卡及镇岳SSD主控芯片,结合阿里云新一代网络架构,单一AI集群可扩展至50万卡。平头哥已覆盖AI芯片、服务器CPU、互联、网络和存储等数据中心核心芯片。
商业应用方面,基于M890的超节点已大规模应用,跑通Qwen3.8、Kimi K3等超过2万亿参数的模型。截至2026年6月,真武系列已服务超过650家企业客户。
CPU路线同步推进。平头哥计划2027年推出倚天720和倚天730,其中倚天730首次采用全自研CPU微架构,单核SPECint 2017/GHz性能最高达到倚天710的1.4倍;2029年推出采用第二代自研核的倚天750,并支持通过ICN总线与真武AI芯片直接互联,提升CPU与AI芯片协同效率。
AI模型:迈向RSI自我迭代
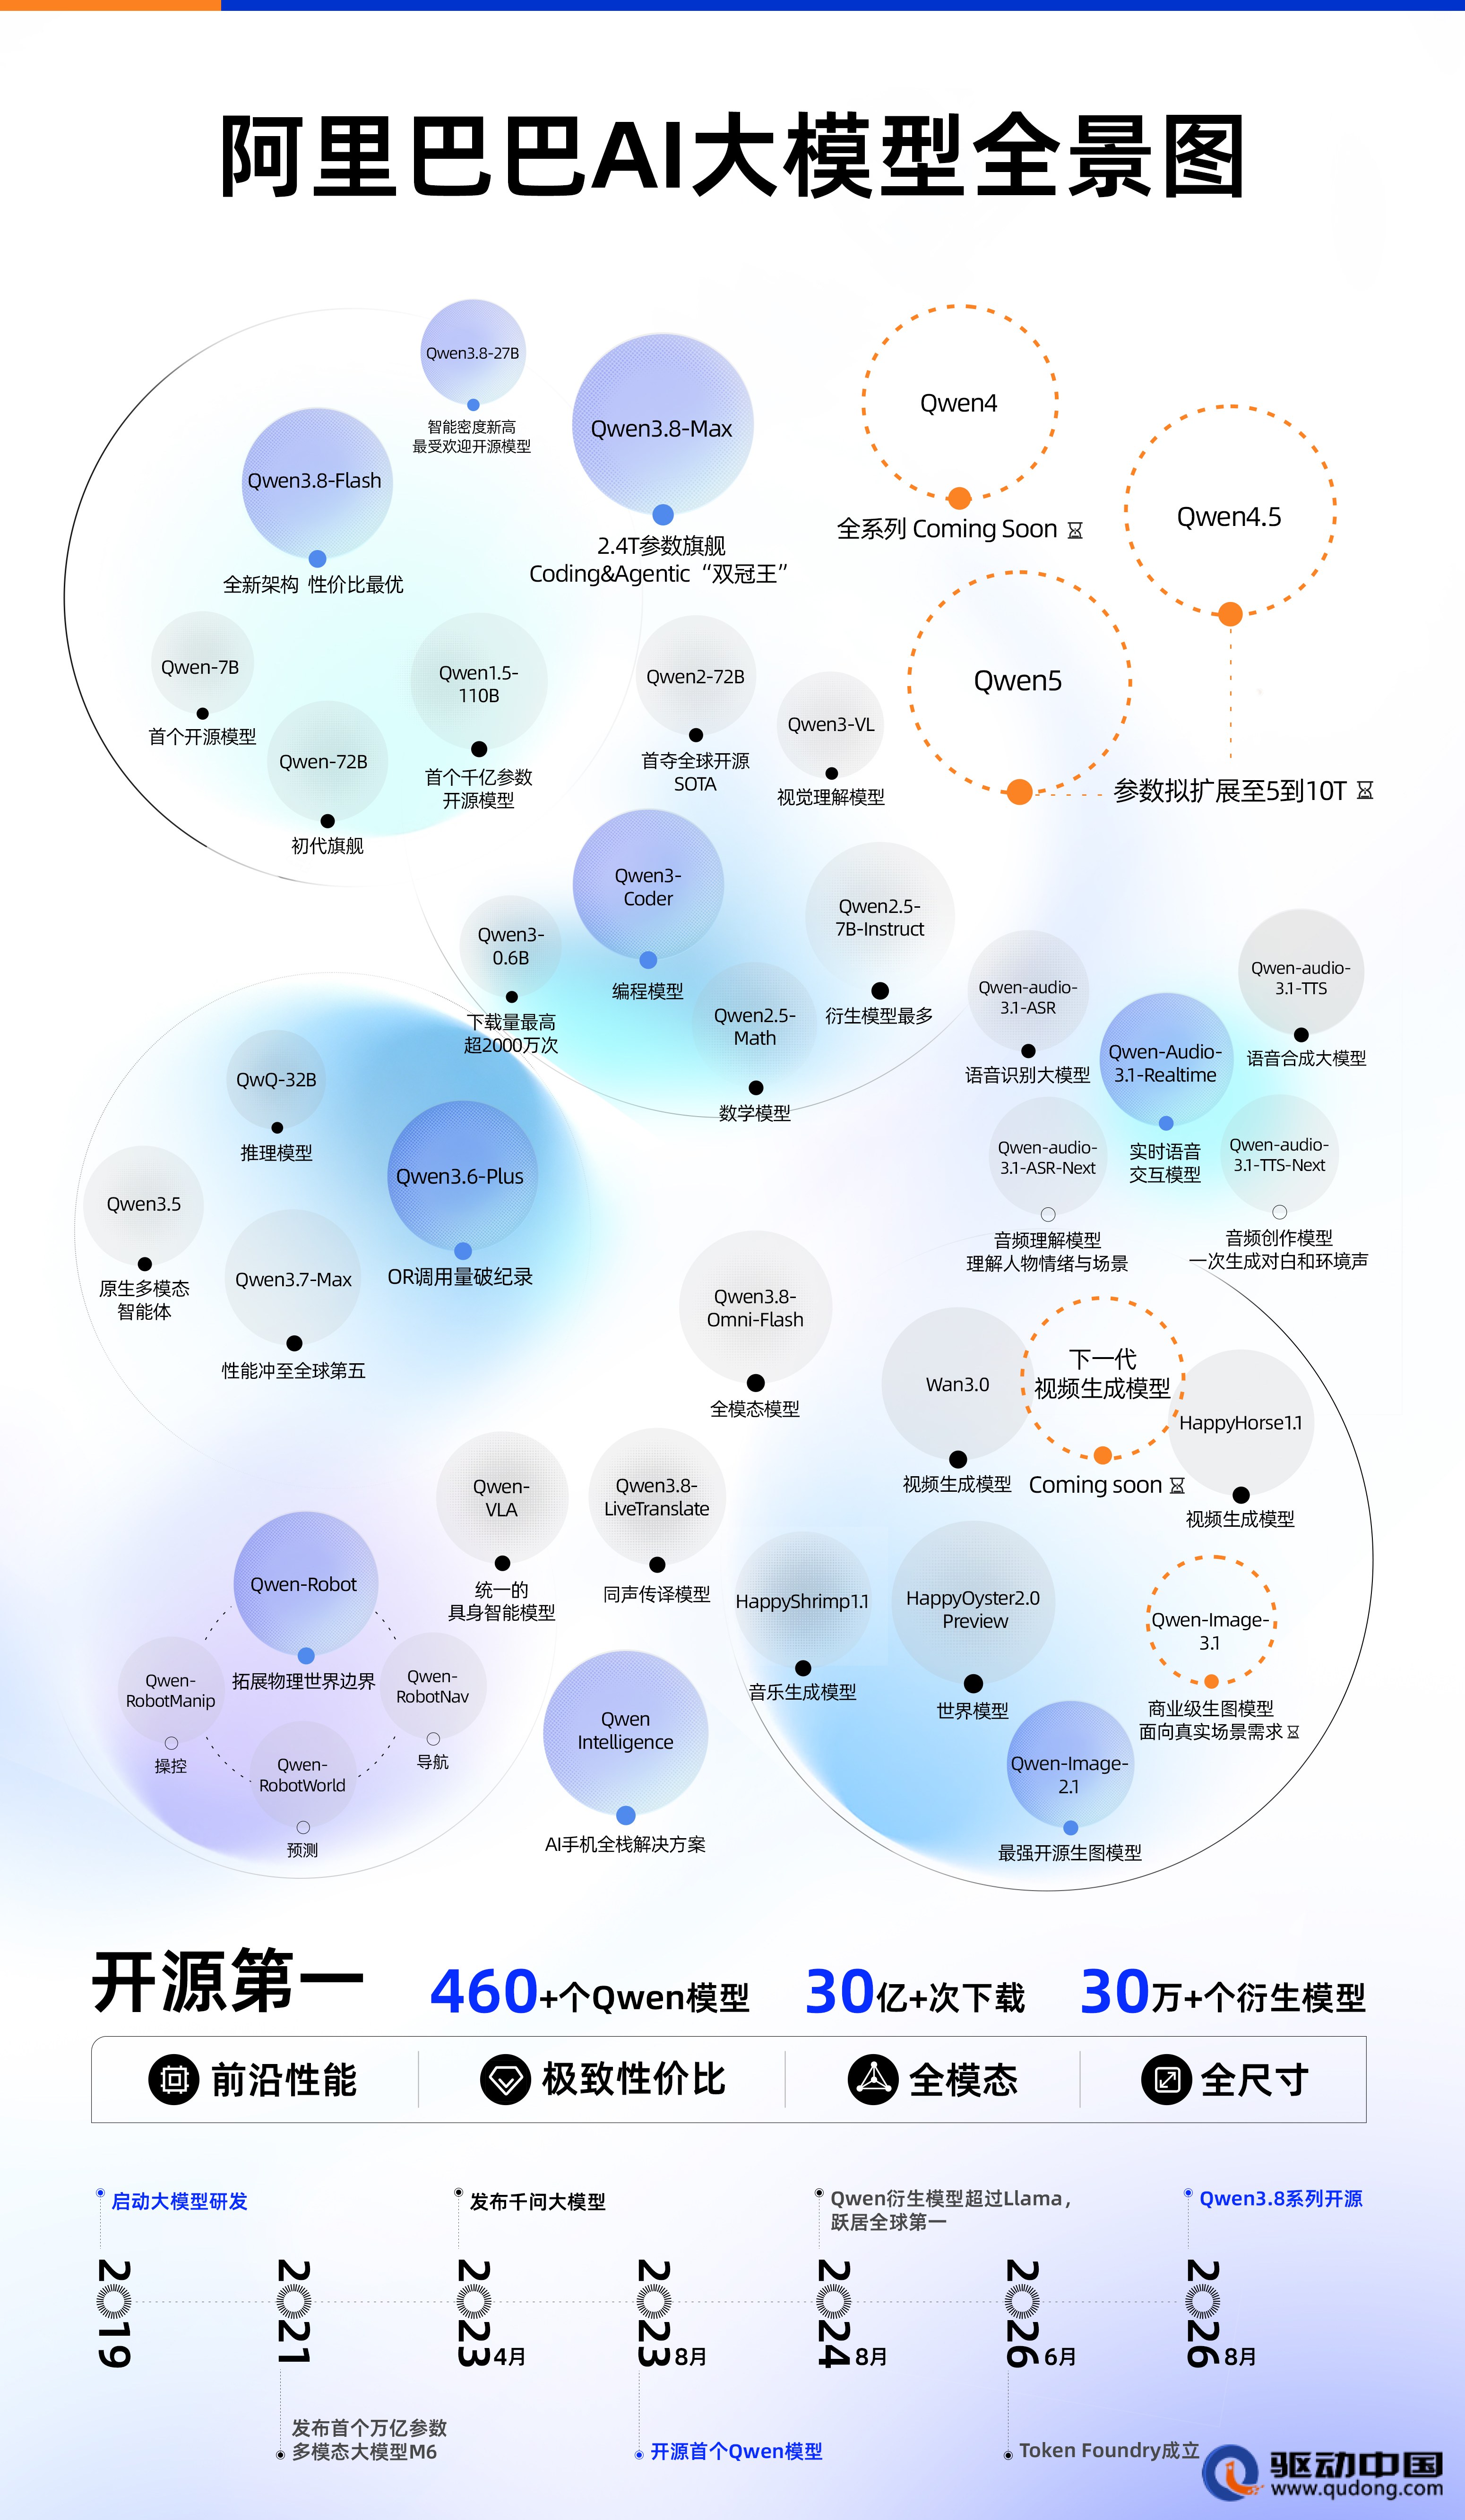
目前,基于新一代架构的Qwen4已投入训练,后续版本计划将模型总参数扩展至5万亿至10万亿,向能够完成更复杂、更长程任务的超级人工智能(ASI)迈进。Qwen3.8-Flash已提前开源下一代模型架构,通过注意力及模型内信息传递机制等核心创新,训练成本骤降90%,激活6B小参数就能获得前沿性能,模型效率大为提高。
递归式自我改进(RSI)已初步进入模型训练、推理及芯模协同环节。据阿里介绍,Qwen3.8-Max在无人参与的情况下,自主搭建训练流程、构造数据、设计实验和定位缺陷,持续迭代超过1个月,完成33轮有效迭代。通过RSI、后训练等联合优化,模型在Artificial Analysis上的得分由40分升至45分。
自我改进也用于提升计算效率。Qwen3.8-Max在此前未接触过的平头哥新款GPU上,自主优化Qwen3.8-Flash的推理框架,使单实例推理吞吐量提升96%;在芯片模型协同设计中,Qwen3.8-Max自主运行超过60小时、调用EDA工具超过万次,完成生产级芯片模块的物理实现优化,将模块面积减少42%。
多模态方面,Qwen3.8-Omni将视频、音频、图片和文字纳入统一理解框架;语音、图像、音乐和世界模型推出新版本;阿里同时推进理解与生成一体化研究,全新的下一代视频生成模型也将于11月发布。
除了追求更高智能,Qwen正努力推进AI普惠。目前,阿里已开源460余个Qwen模型,累计下载量突破30亿次,衍生模型超过30万个。
AI云:扩大算力交付与全球数据中心布局
阿里云正围绕模型持续训练与推理、Agent长时间执行任务等需求,建设覆盖全球的AI基础设施,对GPU、CPU、网络、存储、数据库和工具进行联合优化。基于M890的超节点已支持超过2万亿参数模型的高效推理,并在阿里云实现规模化供给;2026年第四季度将新增服务节点,进一步扩大云上超节点供给。
吴泳铭表示,客户AI需求强劲,行业中长期需求远超阿里当前供给能力,全球AI数据中心相关供应链紧缺仍限制算力增长。阿里巴巴将与合作伙伴共同投入AI基础设施建设,目标是到2032年,阿里云运营的全球数据中心规模超过20GW,以满足持续增长的AI需求。